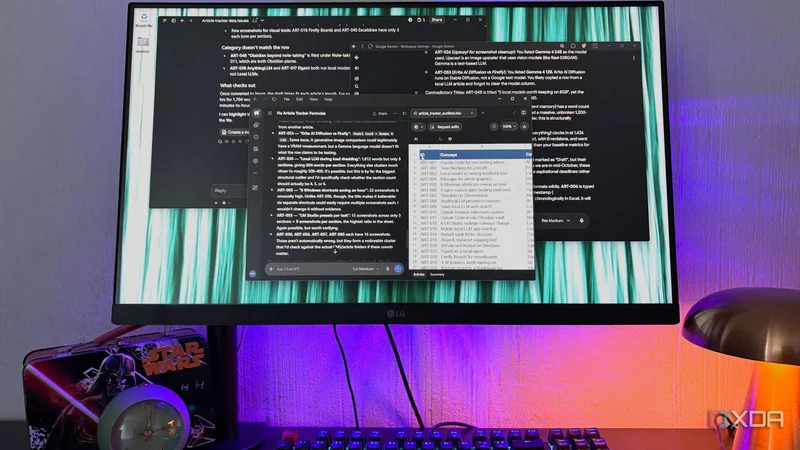
سپردن یک صفحهگسترده (Spreadsheet) بههمریخته به یک دستیار هوش مصنوعی کار سادهای به نظر میرسد؛ بخش فنی ماجرا، یعنی پیدا کردن فرمولهای خطادار (Formula)، دقیقاً همان کاری است که این مدلها برای آن تنظیم شدهاند. اما پرسش اصلی جای دیگری است: اگر اعداد قابل اصلاح باشند و مدل همچنان منظور کاربر را درک نکند، چه اتفاقی میافتد؟ یک کارشناس برای پاسخ به این پرسش، فایل پیگیری مقالات خود را بهطور همزمان در اختیار سه چتبات مطرح قرار داد.
این کاربرگ برای ثبت حجم کاری او استفاده میشود؛ مدتزمان صرفشده برای هر مقاله، تعداد کلمات، بخشها، تصاویر و مواردی از این دست. هدف، بهدست آوردن تصویری کلی از سرعت کار است و همین «زمینه» (Context) است که هوش مصنوعی در آن بیش از اعداد خام دچار مشکل میشود. برای مثال، بخشی از زمانهای نگارش پیشنویس بر حسب دقیقه ثبت شده بود و همین باعث میشد یک مقاله بهظاهر ۴۰ ساعت زمان برده باشد؛ خطایی که کل تصویر سرعت کار را مخدوش میکند.
آزمون یکسان، سه نتیجه کاملاً متفاوت
هر سه مدل در سطح تلاش متوسط (Medium Effort) و با نسخههای پیشرفته آزمایش شدند. کاربر در هر سه سرویس اشتراک پولی فعال داشت و فایل و درخواستها (Prompt) برای همه یکسان بود. نتیجه نشان داد تفاوت اصلی نه در توانایی اصلاح فرمول، بلکه در درک ابهام و پرسیدن سؤال درست است.
جمینای: درخواستی عجیب و فهرستی از کارهای ناتمام
در Gemini از مدل 3.1 Pro استفاده شد. این مدل پیش از آنکه حتی محتوای فایل را بخواند، اعلام کرد که نمیتواند ادامه دهد، چون قابلیتهای هوشمند جیمیل (Gmail) غیرفعال است و از کاربر خواست آنها را روشن کند؛ درخواستی که برای یک پرسش مربوط به صفحهگسترده بسیار نامتعارف به نظر میرسد. نکته جالب اینکه دکمهای برای رد این درخواست وجود نداشت و کاربر مجبور شد دستی به مدل بگوید فقط فایل را بررسی کند.
جمینای بیشتر خطاهای آشکار را پیدا کرد؛ از جمله اشتباه تایپی حرف O و زمانهای ثبتشده بر حسب دقیقه. اما هیچکدام را اصلاح نکرد و در عوض فهرستی از ویرایشها را به کاربر سپرد تا خودش انجام دهد. در ردیفی که تعداد بخشها صفر ثبت شده بود، تنها پیشنهاد داد مقدار آن «حداقل ۱» باشد، بدون آنکه به عدد واقعی فکر کند.
این مدل زمینه (Context) کاربرگ را نیز درک نکرد؛ مقالات با وضعیت Published و Live را «تکمیلشده» شمرد و سپس همه موارد با برچسب Filed را بهعنوان کارهای عقبافتاده توصیف کرد، در حالی که معنای این برچسب برای کاربر دقیقاً برعکس است. همه ردیفهای مربوط به یادداشتبرداری نیز زیر نام Obsidian دستهبندی شدند، هرچند دو مورد از آنها هیچ ارتباطی با این ابزار نداشتند. جمینای یکی از ردیفهای جابهجاشده را هم شناسایی کرد؛ یک مطلب کوتاه Excalidraw که ناگهان ۱۴۲۶ کلمه در دو ساعت ثبت کرده بود، اما نظریهاش این بود که کاربر از کمک خودکار بهره گرفته است؛ فرضی که به گفته او کاملاً نادرست است.
چتجیپیتی: بازسازی کامل کاربرگ
در ChatGPT از مدل GPT-5.6 Sol استفاده شد. این مدل در تلاش نخست با خطای مهلت زمانی (Timeout) مواجه شد، اما برخلاف رقیب، توضیح داد چه اتفاقی افتاده و با تنظیمات دقیقتری دوباره تلاش کرد. پردازش حدود چهار دقیقه طول کشید و خروجی، یک کاربرگ (Workbook) کاملاً بازسازیشده بود؛ همه خطاهای فرمول اصلاح شده و تاریخهای متنی نیز بهدرستی تبدیل شده بودند تا جمعهای ماهانه و دستهبندیها سرانجام درست محاسبه شوند.
این مدل در هر مرحله یک فایل سالم برای بررسی ادعاهای خود ارائه میکرد. پاسخ نخستش کاملاً دقیق نبود و تعداد مقالات تکمیلشده را ۵۰ اعلام کرد، اما پس از پیگیری کاربر، همه وضعیتها را بازبینی کرد و اعلام کرد اگر برچسب Filed به معنای اتمام و ارسال مقاله باشد، عدد واقعی ۵۷ است؛ دقیقاً همان چیزی که کاربر در ذهن داشت. سپس خلاصه را طوری بازسازی کرد که هر دو عدد را کنار هم نشان دهد.
با این حال، در مورد شمارش کلمات جابهجاشده عملکرد ضعیفی داشت. مقالهای با ۱۸۱۲ کلمه در تنها سه بخش را بهعنوان داده پرت (Outlier) علامت زد، اما چون دادهها خراب به نظر نمیرسیدند آن را رها کرد و در درخواست آخر همان ردیف را بزرگترین ناهنجاری ساختاری فایل خواند، در حالی که همچنان شمارش کلمات را منطقی میدانست.
کلود: پرسیدن پیش از حدس زدن
در Claude از مدل Opus 5.5 استفاده شد. یکی از مراحل پردازش نیمهکاره شکست خورد، اما مدل بدون هیچ مشکلی بازیابی شد و یک صفحهگسترده اصلاحشده بههمراه توضیح کوتاهی از خطا ارائه داد.
این مدل بهجای حدس زدن، متوجه شد که مقدار ستون Sections در ردیفهای متناوب با ستون Related Links مطابقت دارد و بر همین اساس مقدار گمشده را ۴ تعیین کرد و یادداشتی روی سلول گذاشت تا کاربر آن را بازبینی کند. همچنین در نخستین پاسخ خود درباره برچسب Filed پرسید که آیا باید در کنار Published و Live تکمیلشده به حساب بیاید و در ادامه اشاره کرد که برچسب Live فقط تا اوایل سپتامبر دیده میشود و احتمالاً برچسبی قدیمی است که دیگر استفاده نمیشود.
نکتهای که دو مدل دیگر هرگز به آن نرسیدند، مقایسه بازه «شش هفته گذشته» با تقویم بود؛ کلود متوجه شد دادهها در ۲۵ سپتامبر متوقف شدهاند و پرسید باقی مقالات کجاست. با این حال، این مدل در یک مورد دچار خطا شد و تطابق Related Links با Sections در تمام ۶۰ ردیف را دادهای غیرواقعی تشخیص داد، در حالی که این الگو صرفاً شیوه نگارش کاربر است؛ هرچند خودش به این اشتباه اعتراف کرد.
جمعبندی
هیچیک از سه مدل متوجه نشد که بخشی از شمارش کلمات بهطور کامل جابهجا شده است. ChatGPT نزدیکترین خروجی به یک فایل آماده استفاده را ارائه داد و پرسش برچسب Filed را دقیق پاسخ گفت، اما Claude تنها مدلی بود که پیش از اصرار کاربر، سؤال درست را پرسید و منظور او را فهمید. در اصلاح اعداد، این دو مدل همسطح ارزیابی شدند، اما در درک ابهامهایی مانند روند سرعت کار، برتری از آن Claude بود و Gemini از همان ابتدا در این رقابت حاضر نبود.