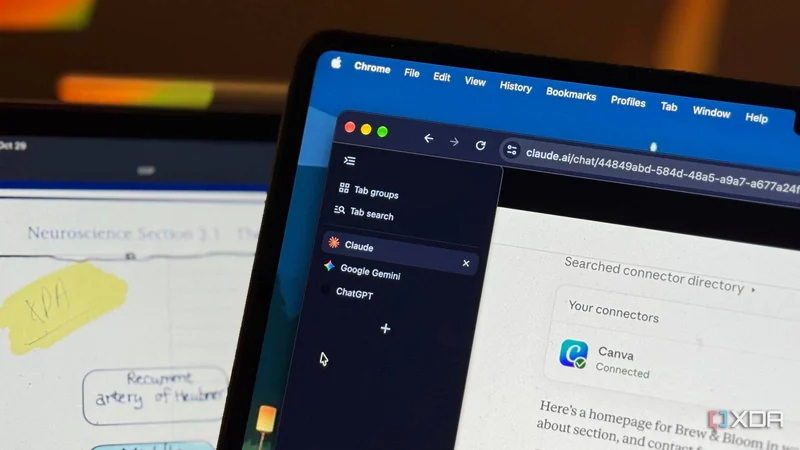
بر اساس گزارش XDA Developers، یک آزمایش یکهفتهای نشان میدهد که چتباتهای هوش مصنوعی (AI Chatbots) در مواجهه با پرامپتهای (Prompt) مبهم عملکرد یکسانی ندارند. در این آزمایش، ChatGPT، Claude و Gemini پنج وظیفه روزمره را با دستورهای عمداً کمجزئیات دریافت کردند تا مشخص شود کدامیک بهتر میتواند کمبود اطلاعات را جبران کند.
چرا پرامپتهای دقیق زیر سؤال رفتند؟
نویسنده مقاله با اشاره به توصیههای بوریس چرنی (Boris Cherny)، خالق Claude Code، و کت وو (Cat Wu)، مدیر محصول Claude Code در Anthropic، توضیح میدهد که مدلهای جدیدتر میتوانند بخشی از ابهام را خودشان مدیریت کنند. با این حال، تفاوت میان حذف دستورهای غیرضروری و حذف کامل اطلاعات مهم وجود دارد. پرسش اصلی این بود که آیا چتباتها در نبود جزئیات، پرسشهای درست را میپرسند، فرضهای منطقی میکنند یا صرفاً پاسخهای عمومی ارائه میدهند.
روش آزمایش: پنج وظیفه روزمره با کمترین جزئیات
برای fairness بیشتر، قابلیت حافظه (Memory) در هر سه چتبات غیرفعال شد و از حالتهای ناشناس یا موقت (Temporary Chat) استفاده شد تا هیچکدام به گفتگوهای قبلی تکیه نکنند. پنج وظیفه انتخابشده عبارت بودند از:
- انتخاب میان تبلت جوهر الکترونیکی (E-ink Tablet) و iPad بدون اطلاع از بودجه، ترجیحات یا کاربرد موردنظر
- برنامهریزی یک سفر سهروزه به توکیو بدون دانستن علایق، بودجه یا ترجیحات سفر
- توضیح مفهوم بازگشت (Recursion) بدون آگاهی از سطح تجربه یا سبک یادگیری کاربر
- ایدهپردازی برای کانال یوتیوب بدون مشخص بودن علایق، مخاطب هدف یا نوع محتوا
- ساخت وبسایت یک کسبوکار بدون توضیح درباره نوع کسبوکار یا قابلیتهای موردنیاز
هر سه چتبات دقیقاً پرامپت یکسانی دریافت کردند و هیچ دستور اضافهای از پیش به آنها داده نشد. همچنین برای کاهش تأثیر ترجیحات شخصی، یک هوش مصنوعی جداگانه پاسخها را بدون اطلاع از هویت تولیدکننده ارزیابی کرد.
جمینای: پاسخ درست، اما حداقلی
Gemini در این آزمایش ضعیفترین عملکرد را داشت. پاسخهای آن لزوماً نادرست یا غیرقابلاستفاده نبودند و در هر پنج آزمون منظور پرسش را درک کرد؛ اما در مقایسه با ChatGPT و Claude معمولاً از حداقل لازم فراتر نمیرفت. برای نمونه، در توضیح بازگشت (Recursion)، ChatGPT یک راهنمای گامبهگام تصویری، نمونه کد پایتون (Python) و حتی یک پرسش چندگزینهای برای سنجش درک ارائه داد و Claude نیز مفهوم را بهخوبی شکافت. اما Gemini تنها به تشبیهها و توضیحهای ساده بسنده کرد و هیچ نمونه کدی ارائه نداد.
در انتخاب میان تبلت جوهر الکترونیکی و iPad نیز ChatGPT یک پرسشنامه تعاملی برای محدودکردن نیازها ارائه کرد و Claude مقایسهای مختصر اما کاربردی داد؛ Gemini تفاوت دو دستگاه را توضیح داد، اما به اندازه کافی به تصمیمگیری کمک نکرد. در برنامهریزی سفر سهروزه به توکیو هم ChatGPT برنامهای دقیق با نقشه، برآورد هزینه و راههای شخصیسازی ارائه کرد و برنامه Claude منظم و قابلپیگیری بود؛ برنامه Gemini معقول به نظر میرسید، اما یکی از قابلیتهای تعاملی آن در زمان آزمایش بارگذاری نشد.
چتجیپیتی و کلود: دو رویکرد متفاوت
ChatGPT و Claude هر دو بهتر از Gemini کمبود جزئیات را جبران کردند، اما روش آنها متفاوت بود. ChatGPT غالباً ابتکار عمل را به دست میگرفت و حتی با اطلاعات ناکافی، پاسخی کاملتر ارائه میکرد و سپس راههایی برای شخصیسازی یا اصلاح پاسخ پیشنهاد میداد. در بسیاری از موارد نیز بهجای درخواست ساده برای جزئیات بیشتر، یک پرسشنامه تعاملی با گزینههای چندگزینهای میساخت تا کاربر با چند کلیک پاسخ را دقیقتر کند.
Claude اما در برخی موقعیتها بهتر میدانست چه زمانی باید پرسش بپرسد. در وظیفه ساخت وبسایت کسبوکار، ChatGPT بیدرنگ یک وبسایت HTML قابلدانلود تولید کرد و Gemini قالبی نسبتاً عمومی ارائه داد؛ اما Claude پیش از نوشتن کد، اطلاعات بیشتری درباره کسبوکار خواست. پس از ارائه جزئیات، وبسایتی برای یک کافه خیالی به نام Brew & Bloom ساخت که به نیاز مطرحشده نزدیکتر بود. این نمونه نشان داد که ابتکار عمل ChatGPT همیشه مزیت نیست و فرضهای عجولانه میتواند خروجی را کمشخصیسازیشده کند.
نتیجهگیری
نتیجه کلی آزمایش روشن است: Gemini هنوز وقتی جزئیات از پرامپت حذف میشود با دشواری بیشتری روبهرو میشود، در حالی که ChatGPT و Claude بهتر میتوانند شکاف اطلاعاتی را پر کنند؛ چه با فرضهای منطقی، چه با پیشبینی نیاز بعدی کاربر و چه با پرسیدن اطلاعات بیشتر. با این حال، پرامپتهای دقیق بهکلی منسوخ نشدهاند و ارائه زمینه بیشتر همچنان هنگام وجود نیازهای مشخص کمککننده است. اما شاید لازم نباشد برای هر چتبات و هر وظیفه، زمان زیادی صرف ساخت پرامپت بینقص شود.