در سالهای اخیر، خودمیزبانی مدلهای هوش مصنوعی به عنوان یک راهکار محبوب برای حفظ حریم خصوصی دادهها و کاهش هزینهها مطرح شده است. در این راستا، محققان به بررسی هزینههای واقعی برق ناشی از اجرای مدلهای هوش مصنوعی محلی پرداختهاند.
روش اندازهگیری هزینهها
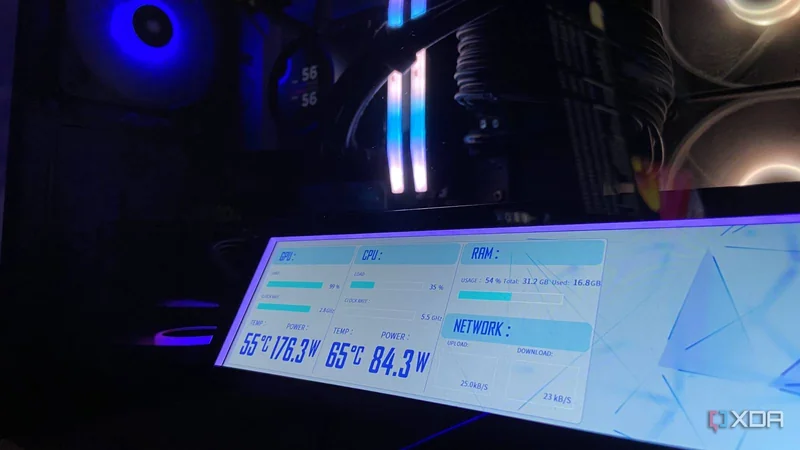
برای اندازهگیری هزینههای برق، از ابزار benchmark به نام llama-bench استفاده شد و مصرف برق با ابزارهای HWiNFO و nvidia-smi در یک سیستم با کارت گرافیک RTX 4070 Ti Super ثبت گردید. نتایج نشان داد که هزینه برق به مراتب کمتر از هزینه اشتراکهای ماهانه خدمات ابری است.
نتایج اندازهگیری
در این آزمایش، مدل Qwen3.6-35B-A3B مورد بررسی قرار گرفت و هزینههای مربوط به خواندن و تولید توکنها محاسبه شد. نتایج به صورت زیر است:
- خواندن یک پرامپت: 0.42¢ هزینه به ازای هر میلیون توکن
- تولید توکنها: 14.9¢ هزینه به ازای هر میلیون توکن
مقایسه با اشتراکهای ابری
در مقایسه با هزینههای اشتراکهای ابری، هزینههای محاسبه شده برای مدل محلی به مراتب کمتر است. برای مثال، هزینه تولید توکن در مدلهای ابری مانند ChatGPT و Claude به ترتیب 30¢ و 20¢ به ازای هر میلیون توکن است، که نشاندهنده تفاوت قابل توجهی با هزینههای محلی است.
نتیجهگیری
نتایج این تحقیق نشان میدهد که هزینههای برق ناشی از اجرای مدلهای هوش مصنوعی محلی به هیچ وجه به اندازهای نیست که مانع از خودمیزبانی شود. به طور کلی، اجرای مدلهای محلی نه تنها از نظر حریم خصوصی بلکه از نظر اقتصادی نیز به صرفهتر است.