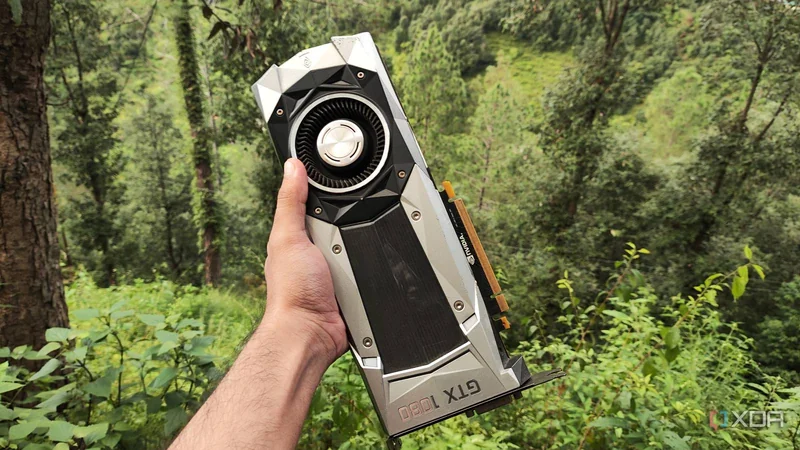
با افزایش روزافزون قیمت سختافزار، بسیاری از کاربران به استفاده دوباره از قطعات قدیمی روی آوردهاند. بر اساس گزارش XDA Developers، یک کاربر توانسته کارت گرافیک قدیمی GTX 1080 را برای اجرای مدلهای زبانی بزرگ محلی (Local LLM) به کار بگیرد؛ آن هم در حالی که این کارت حدود ۱۰ سال عمر دارد و تنها ۸ گیگابایت حافظه ویدئویی (VRAM) در اختیار دارد.
چرا GTX 1080 برای LLMهای محلی؟
اجرای مدلهای هوش مصنوعی بهصورت محلی معمولاً به حافظه ویدئویی زیاد و معماری جدید پردازنده گرافیکی نیاز دارد. اما مدلهای مبتنی بر معماری ترکیب خبرگان (Mixture-of-Experts یا MoE) امکان استفاده همزمان از حافظه رم (RAM) و VRAM را فراهم میکنند. در این معماری، هر توکن تنها از زیرمجموعه کوچکی از شبکههای خبره عبور میکند؛ بنابراین لازم نیست همه وزنهای مدل روی GPU بارگذاری شوند.
نویسنده مقاله توانسته لایههای توجه، لایههای خبره فعال و تعبیهها (Embeddings) را روی GTX 1080 نگه دارد و بخشی از وزنهای خبره را با پرچم n-cpu-moe-- به پردازنده و حافظه سیستم منتقل کند. همین موضوع باعث شده کارت گرافیک قدیمی همچنان برای وظایف بهرهوری و کدنویسی قابل استفاده باشد.
درایورهای Nvidia و پاستروی LXC در Proxmox
نخستین چالش، سازگار کردن کارت گرافیک با سیستمعامل بود. کاربر از Proxmox بهعنوان بستر اصلی و یک کانتینر LXC مبتنی بر Debian برای موتور استنتاج (Inference Engine) استفاده کرده است. به گفته او، نسخههای اخیر درایور GTX 1080 با Proxmox و هسته pve-kernel 7.x مشکل داشتند، اما درایور نسخه 580.119.02 انویدیا برای رفع این ناسازگاری منتشر شده است. در ادامه، نصب درایور 580.173.02 انجام شده و با اجرای nvidia-smi مشخص شده که GPU بهدرستی شناسایی میشود.
- نصب بستههای لازم با apt install و دریافت هدرهای pve-kernel
- دانلود و اجرای فایل نصب درایور Nvidia
- استفاده از اسکریپتهای انجمن PVE برای راهاندازی LXC و پاستروی GPU
- انتقال فایل درایور به LXC با دستور pct push و نصب آن با پرچم no-kernel-modules--
llama.cpp با بکاند Vulkan
برای اجرای مدلها، llama.cpp بهعنوان موتور استنتاج انتخاب شده است. به گفته کاربر، این ابزار نسبت به گزینههایی مانند Ollama سبکتر است و امکان سفارشیسازی بیشتری در اختیار میگذارد. او بکاند Vulkan را برای GTX 1080 مناسبتر از CUDA دانسته، زیرا در کارتهای نسل Pascal سازگاری پایدارتری ارائه میدهد.
پس از نصب بستههای Vulkan و ساخت فایل nvidia_icd.json برای شناسایی GPU توسط API، پروژه llama.cpp با تنظیم GGML_VULKAN=ON کامپایل شده است. این مرحله زمینه اجرای مدلهای محلی را روی کارت گرافیک فراهم میکند.
نتایج اجرای مدلهای MoE
کاربر مدل حجیم Qwen3.6-35B-A3B را با تنظیمات مناسب و انتقال بخشی از وزنها به CPU اجرا کرده است. سرعت پیشپردازش (Prefill) در این مدل بین ۵۰ تا ۷۰ توکن بر ثانیه و سرعت پردازش واقعی حدود ۱۵.۲ توکن بر ثانیه گزارش شده است. این نتیجه با توجه به اندازه زمینه (Context Size) برابر با ۱۰۰۰۰۰ توکن و عمر ۱۰ ساله کارت گرافیک قابل توجه است.
مدل Gemma-4-26B-A4B نیز در مرحله پیشپردازش نتایج مشابهی داشته، هرچند سرعت پردازش آن کمی کمتر و حدود ۱۴.۶ توکن بر ثانیه بوده است. برای وظایفی که به سرعت بسیار بالا نیاز دارند، مدل سبکتر Gemma 4 E4B روی همین کارت با سرعت ۲۳۸ توکن بر ثانیه در پردازش پرامپت و حدود ۴۸ توکن بر ثانیه در تولید پاسخ اجرا میشود.
نتیجهگیری
این آزمایش نشان میدهد کارتهای گرافیک قدیمی و متوقفشده نیز میتوانند با انتخاب درست نرمافزار، درایور و معماری مدل، برای اجرای LLMهای محلی مفید باشند. کاربر قصد دارد GTX 1080 را بهعنوان ایستگاه اختصاصی میزبانی مدلهای زبانی برای Home Assistant، Vane و ابزارهای بهرهوری و کدنویسی نگه دارد.