در حالی که قیمت حافظه رم (RAM) بسیار بالا رفته و نوآوریهای متعددی در حوزه مدیریت حافظه لینوکس (Linux Memory Management) دنبال میشود، مجموعه پچ جدیدی که روز دوشنبه منتشر شد، هدفش بهبود عملکرد Zswap است؛ یک حافظه پنهان فشرده رم (Compressed RAM Cache) برای صفحات swap.
دو پچ برای کاهش رقابت در Zswap
توسعهدهنده لینوکس، اسامه عارف (Usama Arif)، دو پچ را برای Zswap منتشر کرد تا رقابت درخواستها (Request Contention) در عملیات خواندن (Loads) کاهش یابد. این کار پس از تلاش مشابهی که روی zRAM انجام شده بود، صورت میگیرد. در وضعیت فعلی، ذخیرهسازیها (Stores) و خواندنها (Loads) یک درخواست acomp و mutex مشترک بهازای هر CPU (per-CPU) دارند و همین موضوع به گلوگاه (Bottleneck) تبدیل شده است.
عارف توضیح میدهد: «یک ذخیرهسازی با اولویت پایین میتواند بلافاصله پس از آنکه فشردهساز قفل جریان (Stream Lock) خود را رها میکند، پیشگیری (Preempt) شود، در حالی که هنوز mutex مربوط به zswap را در اختیار دارد؛ سپس یک خواندن با اولویت بالاتر روی همان CPU باید منتظر بماند تا ذخیرهسازی دوباره اجرا شود.» این روند از مجموعه zram سرگئی سنوژاتسکی (Sergey Senozhatsky) دنبال میکند که به همین دلیل آن را تقسیم کرده بود.
جزئیات فنی دو پچ
- پچ اول: درخواستها، انتظارها و mutexهای جداگانه برای فشردهسازی (Compression) و رمزگشایی (Decompression) ایجاد میکند تا خواندنها دیگر منتظر ذخیرهسازیها نمانند، هرچند ممکن است همچنان منتظر یکدیگر بمانند.
- پچ دوم: وقتی الگوریتم همگام (Synchronous) است و به بافت درخواست (Request Context) نیاز ندارد، رمزگشایی با یک درخواست روی پشته (On-Stack Request) انجام میشود. این مورد همه فشردهسازهای نرمافزاری دروندرختی (In-Tree Software Compressors) را پوشش میدهد و در نتیجه این خواندنها هیچ قفل zswap نمیگیرند. الگوریتمهای ناهمگام (Asynchronous) همچنان درخواست و mutex per-CPU را نگه میدارند.
برای فشردهسازهای نرمافزاری، این مجموعه همان تعداد درخواست قبلی را تخصیص میدهد؛ هر بافت per-CPU حدود ۷۲ بایت رشد میکند و مسیر خواندن (Load Path) روی x86-64 حدود ۲۷۰ بایت عمیقتر میشود.
نتایج بنچمارک: کاهش شدید تأخیر
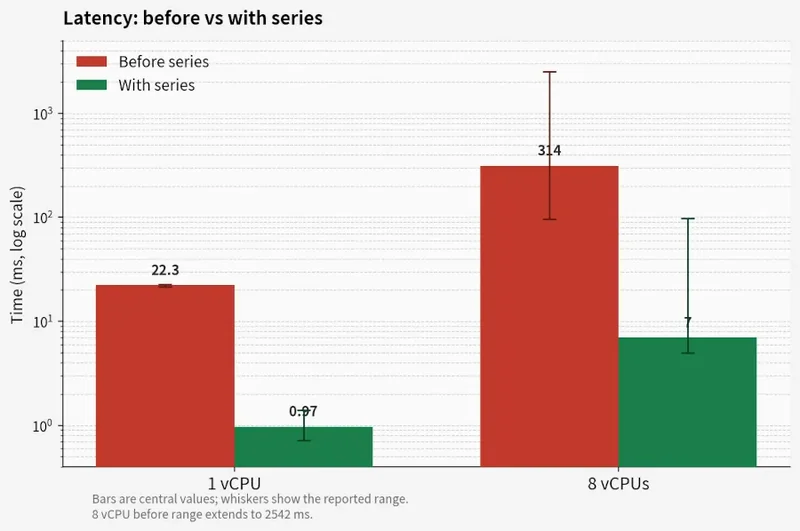
عارف نتایج را با این توضیح ارائه کرده است که اعداد، کندترین خواندن در هر اجرا بهصورت میانه (Median) و کمینه-بیشینه (Min-Max) از ۵ اجرا هستند. هر اجرا ۱۲ ثانیه در یک ماشین مجازی (VM) با zstd، پیشگیری تنبل (Lazy Preemption)، تنظیم vm.page-cluster=0 و swap روی /dev/ram0 انجام شده است. در حالت ۱ vCPU، چهار کارگر با nice +10 حافظه را صفحهبندی و بازخوانی میکنند و یک وظیفه با nice 0 در حال چرخش است. یک خواننده با nice -19 بافر خود را صفحهبندی و زمان هر خواندن را اندازهگیری میکند. در حالت ۸ vCPU، ۱۶ کارگر، ۸ وظیفه در حال چرخش و ۸ خواننده وجود دارد.
- ۱ vCPU: پیش از مجموعه پچ ۲۲.۳ میلیثانیه (۲۱.۶ تا ۲۲.۶) و پس از آن ۰.۹۷ میلیثانیه (۰.۷۲ تا ۱.۴).
- ۸ vCPU: پیش از مجموعه پچ ۳۱۴ میلیثانیه (۹۷ تا ۲۵۴۲) و پس از آن ۷.۰ میلیثانیه (۵.۰ تا ۹۸).
- خواندنهای بیش از ۱۰ میلیثانیه در ۱ vCPU از ۲۶ تا ۳۵ مورد در هر اجرا به هیچ موردی کاهش یافت و در ۸ vCPU از ۳ تا ۱۸ مورد در هر اجرا به حداکثر یک مورد رسید.
برنامه بنچمارک و تست با کمک یک مدل زبانی بزرگ (LLM) نوشته شده است. در مجموع، این تغییرات بهبود بسیار خوبی برای Zswap به نظر میرسد و اکنون در فهرست پستی هسته لینوکس (Linux Kernel Mailing List) در حال بررسی است.