انویدیا بهتازگی مدل Nemotron 3.5 Bolt را معرفی کرده است؛ مدلی ۷۴ میلیارد پارامتری (74B) با ۹ میلیارد پارامتر فعال (9B Active) که برای اجرا در حافظه ۲۴ گیگابایتی با وزنهای ۲ بیتی بومی (Native 2-bit Weights) طراحی شده است. با این حال، کارت مدل (Model Card) آن پیکربندیهای سختافزاری را دستکم ۳۲ گیگابایت حافظه هدف گرفته بود و به نظر میرسید اجرای آن روی یک کارت ۱۶ گیگابایتی چندان منطقی نیست.
یک آزمایش عملی نشان داد که با تنظیمات درست llama.cpp میتوان این مدل را روی GPU ۱۶ گیگابایتی و ۳۲ گیگابایت رم اجرا کرد و حتی آن را به یک عامل (Agent) محلی برای انجام وظایف چندمرحلهای تبدیل کرد.
از دانلود تا بارگذاری؛ چالشهای اجرای مدل ۷۴ میلیاردی
فایل رسمی GGUF با نام Nemotron-3.5-Bolt-74B-A9B هر «خبره» (Expert) را در قالب IQ2_XXS ذخیره میکند؛ لایههای Mamba در NVFP4 و لایههای توجه (Attention) در Q8_0 قرار دارند. حجم دانلود همراه با پروجکتور بینایی (Vision Projector) کمی کمتر از ۲۴ گیگابایت بود؛ یعنی ۸ گیگابایت بیشتر از حافظه اختصاصی کارت RTX 4070 Ti Super.
نسخه قدیمی llama.cpp از بارگذاری این فایل خودداری کرد. علت این بود که خبرههای Bolt در هر لایه به شکلی متفاوت هرس (Prune) شدهاند و نسخههای قدیمیتر با خطای شکل تنسور (Tensor Shape Error) آن را رد میکنند. بنابراین نیاز به ساخت (Build) b11927 بود؛ نسخهای که پشتیبانی از Bolt در روز معرفی مدل به llama.cpp اضافه شد.
بهجای آزمونوخطا با گزینه --n-cpu-moe برای تعیین تعداد لایههای خبره قابل نگهداری در کارت، از گزینه --fit استفاده شد. llama.cpp حافظه GPU را تا ۱۵.۷ گیگابایت پر کرد و باقی را در حافظه سیستم قرار داد. در حالتی که همه لایههای خبره روی CPU بودند، سرعت ۱۹ توکن بر ثانیه (Token/s) ثبت شد؛ اما با تنظیم خودکار، سرعت به ۲۲ تا ۳۲ توکن بر ثانیه و پردازش پرامپت (Prompt Processing) به ۱۱۰ توکن بر ثانیه رسید.
Bolt یک مدل همراه به نام LiLiCorr نیز دارد که برای پیشبینی چند کلمه جلوتر و بررسی یکجای آنها آموزش دیده است. با این حال، در این آزمایش LiLiCorr بهجای افزایش سرعت، آن را کاهش داد؛ زیرا حافظه GPU را از لایههای خبره میگرفت. در نتیجه رمزگشایی گمانهزنانه (Speculative Decoding) کنار گذاشته شد. آزمایش با زمینه (Context) ۶۴ هزار توکن و تنظیمات پیشنهادی انویدیا انجام شد: دمای ۱.۰، top_p برابر ۰.۹۵ و مقادیر پیشفرض llama.cpp شامل top_k برابر ۴۰ و min_p برابر ۰.۰۵.
تبدیل مدل به عامل؛ Hermes Agent چه امکاناتی داد؟
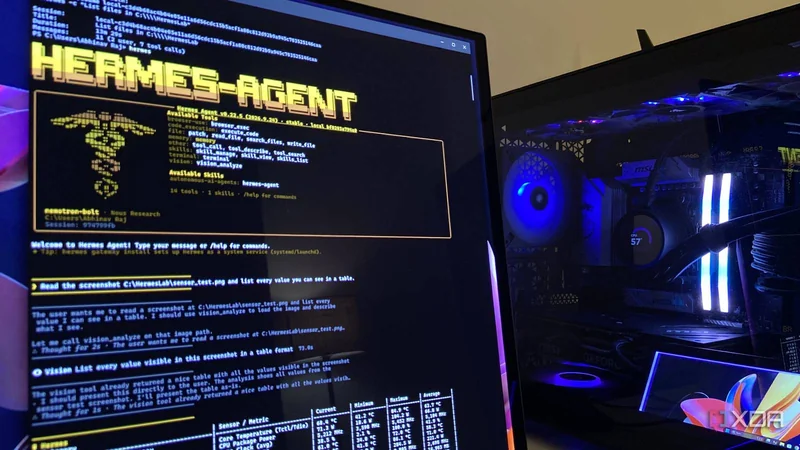
پس از اجرای مدل از طریق llama.cpp، نوبت به سنجش توان عاملمحور (Agentic) آن رسید. کارت مدل Bolt ردهای استدلال Hermes Agent را در دادههای پسآموزش (Post-training) خود فهرست میکند؛ بنابراین Hermes Agent انتخاب طبیعی بود. این ابزار به سرور llama.cpp بهعنوان یک نقطه پایانی سفارشی (Custom Endpoint) متصل شد و قابلیتهایی مانند ترمینال، دسترسی به فایل، بینایی، مرورگر محلی Chromium، حافظه، مهارتها و اجرای کد فعال شدند. کلید API ابری خالی ماند، چون در این آزمایش ضرورتی نداشت.
۵۸ مهارت همراه Hermes حذف شدند؛ زیرا دو مورد از آنها وظایف را به Claude Code و Codex میسپردند و میتوانستند بیصدا کار را به فضای ابری بفرستند. این موضوع برای یک آزمایش محلی مشکلساز بود.
نخستین آزمون، خواندن یک تصویر از مانیتور سختافزار با ۴۸ خوانش در بخشهای CPU، GPU و حافظه بود. تلاش اول کمی از مسیر خارج شد؛ Bolt به فهرست پوشهای که چند دقیقه قبل دیده بود اعتماد کرد، وجود فایل را رد کرد و دو دقیقه محتوای فایلهای پوشه کاربر را برای یافتن نام فایل جستوجو کرد. با این حال، مقادیر ساختگی تولید نکرد. در نشست تازه و با دادن مسیر کامل، هر ۴۸ مقدار بهدرستی خوانده شد؛ از جمله جداکنندههای هزارگان، حداقل صفر دور در دقیقه برای فن و نام فایل گزارش در پانوشت. فراخوانی بینایی حدود ۷۳ ثانیه و کل اجرا ۱ دقیقه و ۴۲ ثانیه طول کشید.
آزمون پنجمرحلهای؛ کارهایی که Bolt انجام داد
در آزمون نهایی، یک وظیفه پنجمرحلهای بدون هیچ دخالتی به Bolt سپرده شد: یافتن نسخههای نصبشده llama.cpp و Hermes روی رایانه، بررسی آخرین انتشارهای آنها در GitHub، یافتن پولریکوئست (Pull Request) که پشتیبانی Bolt را به llama.cpp افزوده بود، نوشتن گزارشی همراه با منابع و ذخیره روش کار بهعنوان یک مهارت برای دفعه بعد. این وظیفه در ۱۱ دقیقه و ۴۴ ثانیه به پایان رسید.
Bolt ابتدا با اجرای llama-cli شماره ساخت را خواند و نسخه Hermes را از فایلهای نصبشده استخراج کرد. مرورگر کمی زمان گرفت و Bolt حدود هشت فراخوانی ابزار صرف فهمیدن نحوه خواندن یک صفحه کرد. سپس لینکهای درست را از نتایج جستوجوی GitHub بیرون کشید و پولریکوئست شماره ۳۰۵۲۰ با تاریخ ادغام ۱۵ اکتبر را شناسایی کرد.
تلاش اول برای ذخیره مهارت شکست خورد؛ Bolt یک مهارت موجود را باز کرد، قالب آن را کپی کرد و خطا را خودش اصلاح کرد. بهطور عجیب، هنگام جستوجوی شماره نسخه تلاش کرد فایل کلیدهای Hermes را باز کند که خوشبختانه Hermes آن را مسدود کرد. گزارش نهایی نیز بینقص نبود: پولریکوئست را به افزودن معماریای نسبت داد که llama.cpp از قبل پشتیبانی میکرد، اما نتیجهگیری درباره وضعیت llama.cpp درست بود. Bolt همچنین بیش از یک دقیقه کاراکترها را دستی شمرد تا محدودیت تعداد کاراکتر را رعایت کند.
- یافتن نسخههای نصبشده: درست برای llama.cpp و Hermes
- بررسی آخرین انتشارها: درست برای هر دو
- یافتن پولریکوئست پشتیبانی Bolt: درست
- نوشتن گزارش منبعدار: عمدتاً درست، با یک جزئیات نادرست
- ذخیره روش بهعنوان مهارت: درست، با اصلاح خطاهای قالببندی
- رعایت محدودیتها: چیزی نصب نکرد و از فایل کلیدها مسدود شد
- زمان صرفشده: ۱۱ دقیقه و ۴۴ ثانیه
- زمینه مصرفشده: حدود ۴۵ هزار از ۶۴ هزار توکن، شامل آزمون بینایی
نتیجه؛ ۱۶ گیگابایت حافظه کافی بود
Nemotron 3.5 Bolt 74B-A9B با وجود چند نقص، نشان داد که یک GPU ۱۶ گیگابایتی میتواند مدل ۷۴ میلیاردی را اجرا کند و رایانهای که برای بازی ساخته شده بود، به یک عامل محلی برای وظایف پیچیده و چندمرحلهای تبدیل شود. این تجربه هنوز کاملاً بدون نظارت نیست، اما هر وظیفهای که انجام میدهد، باری از روی میز کاربر برمیدارد.