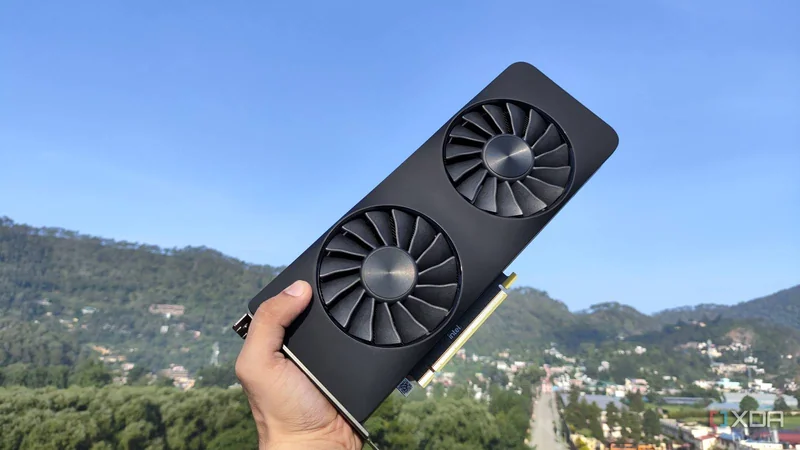
در حالی که کارتهای گرافیک Nvidia بهدلیل اکوسیستم مستند CUDA و هستههای Tensor برای اجرای مدلهای زبانی بزرگ (LLM) محلی توصیه میشوند، یک گزارش تجربی در XDA Developers نشان میدهد که Intel Arc A750 نیز با انتخاب درست نرمافزار میتواند میزبان قابلاتکایی برای استنتاج مدلهای سبک باشد. در این آزمایش، کنار گذاشتن Ollama و استفاده از llama.cpp با پشتیبانی Vulkan، عملکرد کارت را بهطور محسوسی بهبود داده است.
Ollama؛ راهاندازی ساده اما سربار پردازشی
Ollama سالها بهعنوان یکی از گزینههای ساده برای اجرای مدلهای هوش مصنوعی محلی شناخته میشود؛ زیرا نصب و راهاندازی آن آسان است و کاربر میتواند با دستوری کوتاه مانند ollama run و نام مدل، مدل موردنظر را اجرا کند. همین سادگی باعث شده بود که این ابزار در پروژههایی مانند VS Code، Home Assistant و سرویسهای کانتینری نیز مورد استفاده قرار گیرد.
با این حال، گزارش XDA Developers نشان میدهد که Ollama برای همه سختافزارها و همه سناریوها انتخاب بهینهای نیست. این ابزار در زیرساخت از llama.cpp استفاده میکند، اما لایه مدیریت مبتنی بر Go در آن سربار پردازشی قابلتوجهی ایجاد میکند. همچنین پنجره زمینه (Context Window) پیشفرض ۴۰۹۶ توکنی آن برای گفتگوهای طولانی بسیار محدود است.
در آزمایشی که با مدل Gemma 4 E4B (Q4_K_M) روی یک کانتینر LXC مجهز به Intel Arc A750 انجام شد، نرخ تولید توکن (Token Generation Rate) در محدوده ۱۹ تا ۲۲ توکن بر ثانیه قرار داشت. این عدد غیرقابلاستفاده نیست، اما در مقایسه با نتیجهای که با موتور استنتاج (Inference Engine) مناسبتر بهدست میآید، عقبماندگی محسوسی نشان میدهد.
llama.cpp با Vulkan؛ بهترین نتیجه روی Arc A750
نویسنده گزارش برای آزمایشهای خود از یک سرور قدیمی با دو پردازنده Xeon E5-2650 V4 و ۶۴ گیگابایت حافظه DDR4-ECC استفاده کرده است. این سیستم میزبان Proxmox بوده و llama.cpp در چند کانتینر LXC با قابلیت عبور مستقیم GPU (GPU Passthrough) اجرا شده تا عملکرد گزینههای مختلف مقایسه شود.
در میان گزینههای مبتنی بر سختافزار اینتل، نسخه Vulkan از llama.cpp بهترین نتیجه را ارائه داده است. در این پیکربندی، مدل Gemma 4 E4B توانسته نرخ تولید توکن را به حدود ۳۳ توکن بر ثانیه برساند؛ رقمی که نسبت به عملکرد Ollama در همان سختافزار بهبود چشمگیری دارد.
OpenVINO و SYCL؛ گزینههایی که جواب ندادند
OpenVINO معمولاً بهعنوان یکی از گزینههای پیشنهادی برای وظایف هوش مصنوعی روی سختافزار اینتل مطرح میشود و llama.cpp نیز بکاندی مبتنی بر آن دارد. با این حال، در این آزمایش، حتی مدلهای سبک نیز روی OpenVINO دچار کرش میشدند و تلاشها برای عیبیابی مشکل نتیجهای نداشت.
SYCL نیز گزینه دیگری بود که نتیجه رضایتبخشی به همراه نداشت. ساخت llama.cpp بر پایه SYCL دشوار بود و پس از پیکربندی نیز عملکرد ضعیفی ارائه داد؛ بهگونهای که Gemma 4 E4B در این محیط تنها حدود ۳ توکن بر ثانیه تولید میکرد. حتی کامپایل مجدد از ابتدا نیز این نتیجه را تغییر نداد.
فلگهایی برای پاسخگویی بهتر در گفتگوهای طولانی
علاوه بر تغییر موتور استنتاج به llama.cpp مبتنی بر Vulkan، استفاده از چند فلگ (Flag) نیز به بهبود تجربه اجرای مدل کمک کرده است:
- -fa on: فعالسازی توجه فلش (Flash Attention) که پردازش پرامپت (Prompt Processing) را در مرحله پیشپر کردن (Prefill Phase) سریعتر میکند و مصرف حافظه ویدئویی KV (KV VRAM) را در جلسات طولانی کاهش میدهد.
- --ubatch-size 2048: افزایش تعداد توکنهایی که GPU میتواند پردازش کند و در نتیجه بالا رفتن نرخ تولید توکن تا حدود ۳۵ توکن بر ثانیه؛ البته این تنظیم برای مدلهای سبکتر مناسب است و در مدلهای سنگینتر خطر خطای کمبود حافظه (Out-of-Memory) وجود دارد.
- --mmproj: انتقال فایلهای پروجکتور چندوجهی (Multimodal Projector) به مدل زبانی برای اجرای وظایف استنتاج تصویری.
جمعبندی؛ Arc A750 هنوز برای مدلهای سبک کارآمد است
بر اساس این گزارش، پیکربندی فعلی Arc A750 با llama.cpp مبتنی بر Vulkan هنوز بهینهسازی کامل نشده است، اما با توجه به قیمت پایین این کارت در مقایسه با سایر گزینهها، نتیجه بهدستآمده رضایتبخش ارزیابی میشود. مدل Gemma 4 E4B نیز میتواند وظایف استنتاج را برای سرویسهایی مانند Home Assistant، Blinko، Paperless-GPT و Karakeep انجام دهد. به همین دلیل، این کارت قدیمی میتواند همچنان بهعنوان میزبان اصلی بارهای کاری سبک هوش مصنوعی محلی مورد استفاده قرار گیرد.