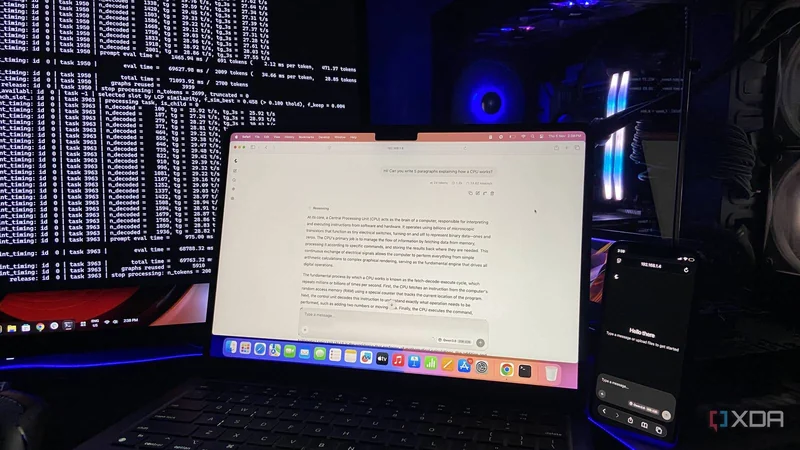
بر اساس گزارش منتشرشده، یک کاربر نشان داده است که کارت گرافیک (GPU) در بسیاری از رایانههای شخصی بیشتر وقت خود را بیکار میگذراند و تنها هنگام اجرای بازی، رندر صحنه یا شبیهسازی فعال میشود. همین موضوع زمینهای شده تا رایانه مجهز به RTX 4070 Ti Super به یک سرور اختصاصی هوش مصنوعی (AI Server) در خانه تبدیل شود و مدل Qwen3.6-35B-A3B روی دستگاههایی اجرا شود که بهتنهایی توان اجرای بومی آن را ندارند.
راهاندازی سرور محلی با یک فرمان
در این تجربه، از llama.cpp برای استنتاج محلی (Local Inference) استفاده شده است. دو پیشنیاز اصلی، یک نسخه نسبتاً جدید از llama.cpp با شماره ساخت b11927 و فایل مدل GGUF است. مدل انتخابشده Qwen3.6-35B-A3B با نسخه کوانتیزهشده (Quantized) UD-IQ4_XS از Unsloth است. برای تبدیل رایانه به سرور، کافی است در PowerShell فرمان llama-server اجرا شود و پارامتر --host 0.0.0.0 به سرور دستور دهد تا بهجای شنود فقط روی رایانه میزبان، روی شبکه خانگی نیز در دسترس باشد. پارامتر --port 8080 نیز پورت (Port) سرور را تثبیت میکند؛ زیرا llama.cpp قصد دارد در نسخههای آینده پورت پیشفرض را به 9931 تغییر دهد.
رابط وب داخلی (Web UI) llama.cpp هر دستگاه خانه را به یک کلاینت (Client) تبدیل میکند. تنظیمات پیشفرض llama.cpp بهگونهای است که پنجره زمینه (Context Window) را به چند شکاف تقسیم میکند و چند کاربر میتوانند همزمان گفتوگو کنند.
عملکرد کلاینتها تقریباً برابر با میزبان
یکی از مزیتهای اصلی این روش آن است که مدل از رایانه میزبان خارج نمیشود. سرور llama.cpp استنتاج (Inference) را روی کارت گرافیک انجام میدهد و پاسخ را بهصورت متن ساده و توکنبهتوکن (Token) به کلاینت میفرستد. حتی با سرعت ۹۰ توکن بر ثانیه، پهنای باند مصرفی تنها کسری از یک مگابیت بر ثانیه است که هر شبکه وایفای خانگی بهراحتی از عهده آن برمیآید. این روش با استریم بازی تفاوت دارد؛ زیرا در استریم بازی هر فریم بهصورت ویدئو ارسال میشود، اما در اینجا فقط واژهها منتقل میشوند.
در آزمون این کاربر، رایانه میزبان به RTX 4070 Ti Super، پردازنده Ryzen 5 7600X و 32GB حافظه DDR5 مجهز بوده است. برای بهینهسازی عملکرد، پارامترهای (Flag) مشخصی به کار رفتهاند: -ngl 99 برای نگهداشتن بخش اصلی مدل روی حافظه ویدئویی (VRAM)، --n-cpu-moe 8 برای انتقال وزنهای متخصص هشت لایه نخست به حافظه سیستم (System RAM)، -c 32768 برای پنجره زمینه ۳۲ هزار توکن، -np 2 برای دو شکاف گفتوگو، -kvu برای اشتراک زمینه میان شکافها، -fa on و --load-mode none. از آنجا که حجم مدل حدود ۱۷.۷ گیگابایت و حافظه ویدئویی کارت گرافیک ۱۶ گیگابایت است، بخشی از وزنهای مدل ترکیبی متخصصان (Mixture-of-Experts / MoE) به حافظه سیستم منتقل شده است. در استنتاج این مدل، تنها حدود ۳ میلیارد از ۳۵ میلیارد پارامتر فعال میشوند و همین موضوع تقسیم وزنها میان حافظه ویدئویی و حافظه سیستم را کارآمد میکند.
نتیجه تست سرعت در دستگاههای مختلف
- میزبان با llama-bench: ۸۵.۴۹ توکن بر ثانیه
- iPhone بهتنهایی: ۸۸.۴۳ توکن بر ثانیه
- M2 MacBook Air بهتنهایی: ۸۹.۵۶ توکن بر ثانیه
- iPhone در حالت همزمان: ۵۹.۹۱ توکن بر ثانیه
- M2 MacBook Air در حالت همزمان: ۵۹.۰۱ توکن بر ثانیه
مصرف انرژی و محدودیت حافظه ویدئویی
یکی از نکات مهم این راهاندازی، مصرف پایین انرژی در حالت آمادهبهکار است. با وجود بارگذاری مدل و آماده بودن سرور، ابزار nvidia-smi مصرف کارت گرافیک را حدود ۱۴ وات ثبت کرده است؛ یعنی حدود یکدهم مصرف هنگام استنتاج فعال. این مقدار تنها هنگام تولید پاسخ به ۱۳۰ تا ۱۴۰ وات میرسد و پس از پایان ارسال پیام دوباره کاهش مییابد.
محدودیت اصلی، اشغال حافظه ویدئویی است. با اجرای سرور، حدود ۹۶ درصد حافظه ویدئویی کارت گرافیک اشغال میشود؛ یعنی ۱۵.۴ گیگابایت از ۱۶ گیگابایت و تنها حدود ۰.۶ گیگابایت آزاد میماند. این رقم بسته به مدل انتخابشده میتواند متفاوت باشد. استفاده از مدلهای سبکتر یا انتقال لایههای بیشتری از مدل ترکیبی متخصصان به حافظه سیستم میتواند این فشار را کاهش دهد.
جمعبندی
به نظر میرسد بهترین حالت برای چنین راهاندازی، یک سرور خانگی اختصاصی و بدون نمایشگر باشد؛ بهویژه سروری با چند کارت گرافیک که حافظه ویدئویی آنها در غیر این صورت بلااستفاده میماند. با این حال، استفاده از رایانه اصلی نیز ممکن است و راهاندازی آن تنها به یک فرمان نیاز دارد. بسته به میزان حافظه ویدئویی، همه دستگاههای خانه میتوانند به مدلی ۳۵ میلیارد پارامتری با سرعت استنتاج مناسب دسترسی پیدا کنند. این تجربه همچنین میتواند کاربران را به بازنگری در اشتراک ماهانه ۲۰ دلاری خدمات ابری (Cloud) ترغیب کند.