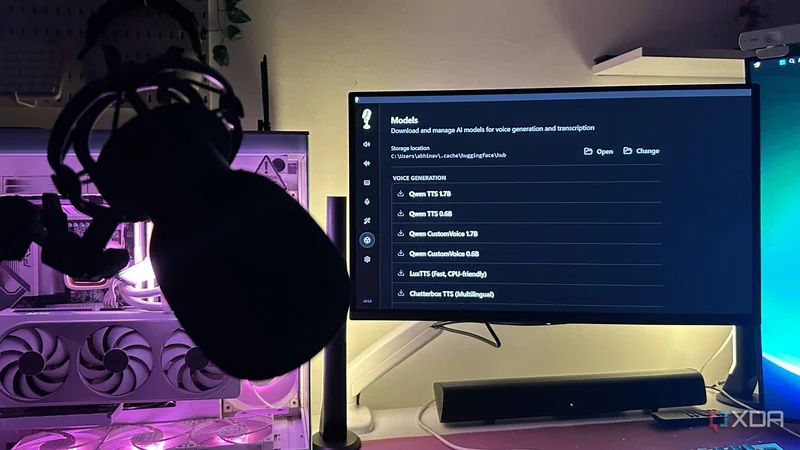
چند ماه پیش، زمانی که شرکت Kyutai ابزار Pocket TTS را منتشر کرد، امکان کلون کردن صدا از یک کلیپ پنجثانیهای فراهم شد؛ تجربهای که این پرسش را به وجود آورد که سامانههای احراز هویت صوتی در بانکها و شرکتهای بیمه تا چه اندازه آسیبپذیر شدهاند. اکنون همین فرآیند، در قالب یک اپلیکیشن دسکتاپ اختصاصی برای ویندوز، لینوکس و مک در دسترس قرار گرفته است؛ ابزاری متنباز با نام Voicebox که نصب آن تنها با چند کلیک انجام میشود، نتایج آن بسیار متقاعدکنندهتر است و کل پردازش روی سختافزار مصرفی کاربر اجرا میشود.
Voicebox چیست و برای چه کسانی طراحی شده است؟
Voicebox یک استودیوی صوتی متنباز و رایگان است که توسط جیمی پاین (Jamie Pine)، بنیانگذار شرکت Spacedrive Technology Inc، توسعه یافته و تحت پروانه MIT توزیع میشود. این ابزار بهعنوان جایگزینی محلی برای دو سرویس پرداختی معرفی شده است: ElevenLabs برای کلون صدا و تبدیل متن به گفتار (Text-to-Speech)، و WisprFlow برای دیکته صوتی. از آنجا که کد این برنامه متنباز است و همه پردازشها روی سختافزار خود کاربر اجرا میشود، استفاده از آن به هیچ حساب کاربری نیاز ندارد.
در قلب این اپلیکیشن، قابلیت کلون صدا قرار دارد. کاربر میتواند یک پروفایل صوتی را از فایل صوتی بارگذاریشده، ضبط با میکروفون، یا صدای در حال پخش روی کامپیوتر — از جمله یک ویدئوی یوتیوب یا پادکست اسپاتیفای — بسازد. سپس پنج موتور گفتاری این برنامه، از جمله Qwen3-TTS شرکت علیبابا و Chatterbox شرکت Resemble AI، میتوانند هر متن تایپشده را با همان صدا و در ۲۳ زبان بازخوانی کنند.
قابلیتهای کلیدی Voicebox
- کلون صدا از فایل صوتی، ضبط میکروفون یا صدای در حال پخش روی سیستم
- پشتیبانی از پنج موتور گفتاری و بازخوانی متن در ۲۳ زبان
- ویرایشگر خط زمانی (Timeline Editor) برای پروژههای چندصدایی
- رَک افکتهای صوتی (Effects Rack)
- دیکته سراسری سیستم مبتنی بر مدل Whisper
- واسط برنامهنویسی کاربردی محلی (Local API) برای گفتوگوی عاملهای کدنویسی با صدای کلونشده
این ابزار برای کاربردهای مشروع متعددی طراحی شده است؛ از تولید کتاب صوتی و پادکست گرفته تا دیالوگ شخصیتهای غیرقابلبازی (NPC)، دستیارهای صوتی و قابلیتهای دسترسپذیری. با این حال، همانگونه که انتظار میرود، امکان استفادههای مخرب نیز وجود دارد. شرایط استفاده شرکت Spacedrive تصریح میکند که بررسیهای مالکیت صدا محدود است و به خود اپلیکیشن دسکتاپ تعمیم داده نمیشود؛ یعنی هیچ مانعی بر سر راه کلون کردن صدای فرد دیگر و استفاده از آن بدون تدابیر حفاظتی سرویسهای میزبانیشده وجود ندارد.
Voicebox چگونه کار میکند و به چه سختافزاری نیاز دارد؟
در لایه زیرین، Voicebox در واقع یک پوسته دسکتاپ (Desktop Wrapper) پیرامون مجموعهای از مدلهای گفتاری محلی است. با ارائه یک نمونه صوتی، ابتدا صدای شما توسط Whisper رونویسی میشود و سپس موتوری مانند Qwen3-TTS با استفاده از فایل صوتی و متن رونویسیشده، گفتار جدیدی با همان صدا تولید میکند. با وجود پیچیدگی فنی، رابط کاربری برنامه استفاده از آن را بسیار ساده کرده است.
وبسایت Voicebox اعلام کرده که تنها سه ثانیه صدا برای کلون کردن کافی است، اما مستندات آن برای بهترین نتیجه، ۱۰ تا ۳۰ ثانیه گفتار شفاف را توصیه میکند. این آستانه برای هر فردی که صدایش بهصورت عمومی منتشر شده — از طریق مصاحبه یوتیوب، پادکست یا حتی یک ریلز اینستاگرام — بسیار پایین است. همچنین پاسخ دادن به تماسهای ناشناس را پرخطرتر میکند، زیرا یک تهدید سایبری تنها با ضبط چند ثانیه از صدای شما میتواند آن را کلون کند.
سد سختافزاری نیز چندان جدی نیست. حداقل نیازمندیها شامل ۸ گیگابایت حافظه رم (RAM)، ۵ گیگابایت فضای ذخیرهسازی و یک پردازنده چندهستهای (Multicore CPU) است و نیازمندیهای پیشنهادی تنها تا ۱۶ گیگابایت رم و ترجیحاً یک پردازنده گرافیکی انویدیا (Nvidia GPU) بالا میرود. دو نکته دیگر نیز در یادداشتهای نسخه (Patch Notes) قابل توجه است: از نسخه ۰.۴.۵ به بعد، مدلهای ذخیرهشده در حافظه پنهان (Cache) میتوانند بدون اتصال به اینترنت گفتار تولید کنند و آخرین بیلد (Build) یعنی نسخه ۰.۵.۰ مربوط به ماه آوریل است. پس از دانلود کامل، هیچ واسطهای میان کاربر و صدای تولیدشده وجود ندارد.
کلون صدا در سه مرحله ساده
آخرین نسخه Voicebox سه روش برای کلون کردن صدا در اختیار کاربر میگذارد: بارگذاری یک کلیپ موجود، ضبط با میکروفون، یا ضبط صدای در حال پخش روی کامپیوتر؛ با این محدودیت که ضبطها حداکثر ۳۰ ثانیه هستند. سپس از کاربر خواسته میشود متن رونویسیشده (Transcript) را وارد کند و پس از آن، فرآیند تقریباً به پایان رسیده است. هیچ بررسی هویتی، اعلام مالکیت یا پرسشی درباره تعلق داشتن صدا به کاربر در صفحه پروفایل وجود ندارد.
پیش از نخستین اجرا، دو دانلود لازم است: نخست مدل Qwen3-TTS 1.7B با حجم حدود ۳.۶ گیگابایت و دوم یک بکاند جداگانه CUDA برای پردازنده گرافیکی RTX 3070، زیرا شتابدهی انویدیا بهصورت پیشفرض همراه برنامه ارائه نمیشود. پس از نصب این دو مورد، کل فرآیند از ضبط نمونه تا تولید صدای کلونشده کمتر از پنج دقیقه زمان برد.
نتایج چشمگیر و نگرانیهای امنیتی
خروجی این مدل در بازتولید ویژگیهای صوتی بسیار دقیق عمل میکند؛ آهنگ کلام (Cadence)، زیر و بمی (Pitch) و رنگ صدا (Timbre) همگی به جملهای منتقل میشوند که کاربر هرگز آن را بر زبان نیاورده است و تنها چند نقص کوچک نشان میدهد که گوینده دقیقاً همان فرد نیست. با این حال، خروجی کاملاً از صدای واقعی قابل تفکیک نیست؛ ناهنجاریهای آکوستیک مرتبط با صداهای تولیدشده توسط هوش مصنوعی همچنان وجود دارند و آشکارسازهای تخصصی یادگیری عمیق (Deep Learning) میتوانند آن را از گفتار طبیعی تشخیص دهند. مشکل اینجاست که چنین ابزارهایی در آن سوی یک تماس تلفنی در اختیار گیرنده ناآگاه قرار ندارند و برای فردی که بهطور منظم با گوینده اصلی تعامل ندارد، صدای کلونشده بهاندازه کافی متقاعدکننده است.