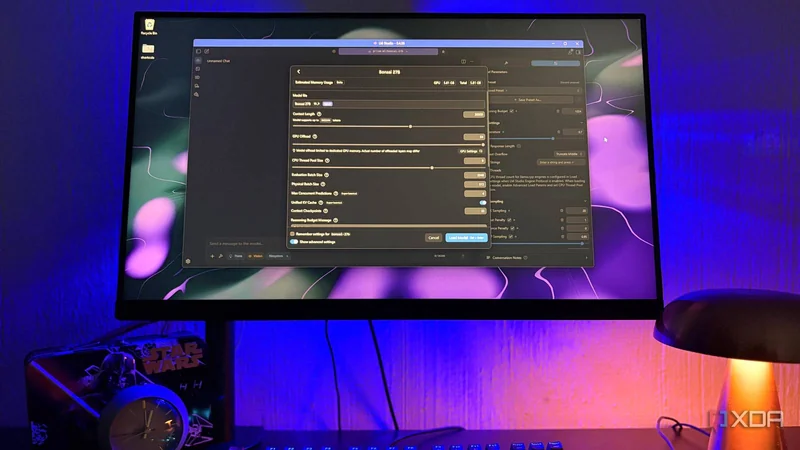
کارتهای گرافیک ۸ گیگابایتی محدودیت سختی برای اجرای مدلهای زبانی محلی ایجاد میکنند. بسیاری از مدلهای جدید بزرگتر از توان این کارتها هستند، اما مدلهایی در محدوده ۴ تا ۹ میلیارد پارامتر مانند Qwen 3.5 9B و Gemma 4 E4B مدتها نیاز کاربران را برطرف کردهاند. با این حال، یک مدل ۲۷ میلیارد پارامتری به نام Bonsai 27B توجهها را جلب کرده است؛ زیرا با فشردهسازی شدید، روی کارت گرافیک ۸ گیگابایتی نیز اجرا میشود.
Bonsai 27B چیست و چگونه فشرده شده است؟
Bonsai 27B محصول PrismML، استارتاپی برگرفته از تحقیقات دانشگاه Caltech، است و بر پایه Qwen3.6 27B ساخته شده است. بنابراین مدلی که کاربر جای Qwen را با آن عوض کرده، از نظر فنی همچنان Qwen محسوب میشود. تفاوت اصلی در میزان فشردهسازی است. یک مدل ۲۷ میلیارد پارامتری در دقت کامل معمولاً بیش از ۵۰ گیگابایت حجم دارد، اما PrismML با ذخیره هر وزن به صورت +۱ یا -۱ و یک مقدار مقیاس مشترک برای هر گروه ۱۲۸ وزنی، حجم را به حدود ۱.۱۲۵ بیت بر هر وزن کاهش داده است.
این مدل در دو نسخه عرضه میشود: نسخه ۱ بیتی با حجم کمی کمتر از ۴ گیگابایت، و نسخه جدیدتر Bonsai 2 که فقط به صورت سهگانه (ternary) ارائه شده و مقدار صفر را به عنوان مقدار سوم اضافه میکند. برخی اجراکنندهها از جمله LM Studio هنوز نمیتوانند این فایلها را اجرا کنند. نسخه استفادهشده در این آزمایش، Q1_0 Staff Pick در LM Studio با حجم ۴.۴ گیگابایت همراه با فایلهای بینایی است؛ حجمی که حتی از Gemma 4 12B QAT نیز کمتر است.
پنجره زمینه و تنظیمات اجرا
Bonsai پنجره زمینه ۲۶۲ هزار توکن (262K-token context window) را از Qwen به ارث برده است. بیشتر توجه (attention) در Qwen3.6 از روش خطی سبکتری استفاده میکند، بنابراین حافظه مورد نیاز برای گفتگوهای طولانیتر بسیار کندتر از بیشتر مدلها رشد میکند. استفاده از کل پنجره زمینه حتی با کش فشرده حدود ۱۰ گیگابایت حافظه میطلبد؛ اما با کمتر از ۸ گیگابایت حافظه در دسترس و نیاز به باقی گذاشتن فضای آزاد برای برنامههای دیگر، عملاً حدود ۳۰ تا ۵۰ هزار توکن زمینه قابل استفاده است.
تنظیمات نمونهبرداری پیشنهادی PrismML نیز استفاده شد: دمای ۰.۷، top-p برابر ۰.۹۵، top-k برابر ۲۰ و جریمههای تکرار و حضور خاموش. یک پیشتنظیم اختصاصی نیز برای استفاده مجدد از این پارامترها ساخته شد.
نقاط قوت: ریاضی، منطق و پیروی از دستور
به نظر میرسد ریاضی و منطق بیشترین مقاومت را در برابر فشردهسازی داشتهاند. آزمونهای PrismML امتیاز ۹۱.۷ را برای ریاضی در برابر ۹۵.۳ برای Qwen کامل ثبت کردهاند. در یک مسئله قیمتگذاری دفترچه با سه گزینه بستهبندی، Bonsai همه ترکیبهای معتبر را بررسی کرد و سپس ارزانترین را انتخاب کرد. این منطق معمولاً نخستین چیزی است که مدلهای ۲ بیتی معمولی از دست میدهند و بهسختی نیز تشخیص داده میشود، چون در گفتگوی عادی همچنان منسجم به نظر میرسند.
در پردازش اسناد نیز Bonsai خلاصهها و فهرستهای ابزار مختصر و تمیزی ارائه داد، حتی برای اسناد طولانیتر و بدون نیاز به تقسیم آنها. پیروی از دستور (instruction following) نیز یکی از حوزههایی بود که پس از فشردهسازی معمولاً افت میکند. در آزمایشی، یک توضیح کوتاه محصول با پنج قاعده پشت سر هم داده شد؛ از جمله کلماتی که نباید استفاده میشد و اینکه قیمت باید به واحد پول کاربر باشد. Bonsai همه آنها را رعایت کرد.
در کدنویسی کوتاه نیز نتیجه قابل قبول بود: امتیاز ۸۹.۶ در HumanEval+ در برابر ۹۵.۱ در دقت کامل. با این حال، اسکریپت رصد پوشه (folder-watcher) که نوشت، در ظاهر کامل به نظر میرسید اما هرگز فایلهای پردازششده را ردیابی نمیکرد؛ بنابراین هر ثانیه همه فایلهای پوشه، از جمله فایل ایندکس خودش را دوباره میخواند.
نقاط ضعف: فراخوانی ابزار، تصویر و سرعت
بزرگترین ضعف Bonsai احتمالاً فراخوانی ابزار (tool calling) است. نسخه ۱ بیتی در آزمونهای عاملمحور و فراخوانی ابزار PrismML امتیاز ۶۶.۰ گرفته، در حالی که Qwen کامل امتیاز ۸۰.۰ دارد؛ این بزرگترین افت در میان همه دستههای آزمون است. برای کارهایی که به ابزار نیاز دارند، همچنان Qwen 3.5 9B انتخاب مطمئنتری است و اگر سختافزار پشتیبانی کند، Qwen 3.6-35B-A3B توصیه میشود.
تصویر نیز نقطه ضعف دیگری است. برای نمونه، با دادن تصویر یک برنامه طراحی و درخواست خلاصه آنچه دیده میشود، Bonsai مقادیر هگز (hex) و ابعاد را درست تشخیص داد، اما فهرست عناصر سه بار تکرار شد و نام برخی عناصر به اشتباه به عنوان تنظیمات خوانده شد. Gemma 4 تصاویر را از طریق تصویرسازیهای سبک (lightweight projections) مستقیماً به مدل میفرستد، بنابراین همچنان انتخاب اصلی برای کارهای تصویری است.
سرعت هم کمی پایینتر است. همان درخواست قیمتگذاری در Bonsai با سرعت ۲۷ توکن بر ثانیه اجرا شد، در حالی که همان درخواست با همان تنظیمات در Gemma 4 E4B سرعت ۳۵ توکن بر ثانیه داشت. این تفاوت چندان بزرگ نیست و قابل تحمل است.
جمعبندی: بالاخره یک مدل بالای ۲۰ میلیارد پارامتر روی این GPU
انتخاب مدل فقط به دلیل بزرگ بودن عدد روی آن عادت درستی نیست، اما نویسنده مقاله میگوید هنوز کاملاً از این عادت رها نشده و هنگام ناتوانی در آزمایش مدلهای بزرگتر کمی حس فومو (FOMO) داشته است. بنابراین شنیدن اینکه این مدل روی سیستم او کار میکند هیجانانگیز بود و تقریباً هم همینطور شد. هنوز کارهایی وجود دارند که ترجیح میدهد به Qwen و Gemma بسپارد، اما Bonsai نشان داده در پیروی از دستور و حل مسائل پیچیده بسیار توانمند است.